- Aktenzeichen
- BEO-2026-054
- Eingang
- Rubrik
- KI und Forschung
- Einstufung
- offen
- Verfasser
- M.V.R.H.S.Rufname
- Bearbeiter
Harness²: Agenten, die ihre eigene Arbeitsumgebung umbauen
         .-.       .-.
        /   \     /   \
       | / \ |   | / \ |
       ||   ||   ||   ||
       ||   ||   ||   ||
     .-'     ' - '     '-.
   ,'    .--.       .--.  '.
 .-.    | _  | ___ | _  |   ,.-.
(   \   .(_).' \ / .(_).'   /   )
 >-  '--------\_|_/--------'  -<
(_ .-------------------------. _)
          `---      ---'-,
          /       .-'''-. ';
          ;      /       ', \        Rabbit of
           )    /          - y=,    Caerbannog
          _/ / /\         ' ;   c
         ((((_/(((_______/_;,v="      ldb
ehrung an monty python. ascii-zeichnung von laura brown (ldb), via asciiart.website.
220501Z oct 26 · 51.7275 N, 11.5148 E
Ein Team von Google Cloud AI Research und der Northwestern University hat am 9. Oktober 2026 auf arXiv das Paper „Harness²: Recursive Agent Harnessing for an Open World“ eingereicht. Erstautor ist Ruiyao Xu von der Northwestern University, dazu kommen sieben Forschende von Google, darunter Tomas Pfister. Der Code liegt auf GitHub, eine Projektseite fasst die Ergebnisse zusammen. Ich fasse hier das Paper zusammen und habe die Benchmarks, auf die es sich stützt, bei ihren Herausgebern nachgelesen. Ausprobiert habe ich nichts.
Worum es geht
Ein KI-Agent besteht nicht nur aus dem Sprachmodell, sondern auch aus seinem „Harness“, also der Ausführungsumgebung drumherum: Werkzeuge, Anweisungen, Abläufe, Ablagen für Zwischenstände. Das Paper geht davon aus, dass die Fähigkeiten eines Agenten von beidem abhängen: „not only on their underlying models but also on their execution harnesses“. Harness² verbessert genau diese Umgebung automatisch und lässt das Modell selbst in Ruhe. Die Umgebung wird laut Paper mit dem Modell kombiniert, „without changing its weights“.
Die Idee, dass ein System sich selbst verbessert, heißt in der Forschung „recursive self-improvement“. Die Autoren nennen zwei Probleme, wenn man das außerhalb des Labors einsetzen will. Erstens sind echte Aufgaben neu, es gibt also keine Musterlösung, an der man eine Änderung prüfen könnte. Zweitens bleiben bisherige Verfahren stark an die jeweilige Aufgabe gebunden und lassen sich schlecht übertragen.
Wie es funktioniert
Laut Paper arbeitet Harness² auf zwei Ebenen:
- Auf Aufgabenebene wird die Umgebung für die aktuelle Aufgabe in einem Schritt „Propose–Probe–Compose“ verfeinert: Änderungen vorschlagen, ausprobieren, zusammensetzen. Statt mit einer Musterlösung arbeitet das Verfahren mit Vergleichen, wie sich der Agent mit und ohne eine Änderung verhält. Dieser Schritt lässt sich mehrfach parallel oder nacheinander ausführen; die Zahl der Durchläufe heißt im Paper k.
- Auf der übergeordneten Ebene werden die übernommenen Änderungen und die Erfahrungen damit in einer Bibliothek gesammelt. Daraus soll der Agent bei künftigen Aufgaben lernen, wie er seine Umgebung besser umbaut.
Als Vergleich treten mehrere Verfahren an. Das wichtigste ist Meta-Harness, das die Umgebung vorab offline an Trainingsaufgaben optimiert und dann fest einsetzt. Harness² dagegen passt sie während der Arbeit an und beginnt bei jedem Benchmark mit einer leeren Bibliothek, die nach jeder Aufgabe wächst.
Wichtig für das Verständnis: Die getesteten Modelle selbst bauen ihre Umgebung nicht um. Sie bleiben laut Paper eingefroren und führen nur aus. Die Änderungen an der Umgebung schreibt standardmäßig ein anderes, größeres Modell, Claude Opus 4.8, das als „Editor“ unter OpenCode läuft. Die Überschrift dieses Beitrags ist insofern eine Vereinfachung: Es ist das Gesamtsystem, das seine Arbeitsumgebung umbaut.
Die Benchmarks
Getestet wurde auf drei Benchmarks aus Berufsfeldern:
- WorkBuddy-Bench mit Büroaufgaben in den Bereichen Code, Web und Office.
- JobBench, ein eigener Benchmark einer anderen Forschungsgruppe für lange berufliche Aufgaben. Dessen Autoren beschreiben 130 Aufgaben aus 35 Berufen; Harness² nutzt nach eigener Angabe 65 Aufgaben, aufgeteilt in 31 zum Lernen und 34 zum Testen.
- LAB, der Legal Agent Benchmark der Rechts-KI-Firma Harvey. Laut Harveys Vorstellung vom Mai 2026 umfasst die erste Version mehr als 1.200 Aufgaben aus 24 Rechtsgebieten, bewertet anhand von über 75.000 von Fachleuten geschriebenen Kriterien. Der Benchmark ist als Open Source veröffentlicht. Harness² testet auf 100 dieser Aufgaben.
Als Modelle dienten GLM-5 und Gemini 3.5 Flash, jeweils mit den offenen Umgebungen OpenCode und Codex, also vier Kombinationen. Jeder Wert ist der Mittelwert aus drei Durchläufen.
Die Zahlen
Die Autoren berichten:
- Schon ein einzelner Schritt bringt bis zu 11,5 Punkte mehr auf WorkBuddy-Bench (GLM-5 mit OpenCode), bis zu 4,5 Punkte auf JobBench und bis zu 11,8 Prozentpunkte bei der Teil-Bestehensquote („Partial“) auf LAB.
- Mehr parallele Durchläufe bringen zusätzlich bis zu 3,9 Punkte (WorkBuddy-Bench), 4,2 Punkte (JobBench) und 6,7 Prozentpunkte (LAB Partial).
- Schwächere Modelle profitieren auf WorkBuddy-Bench und LAB stärker: GLM-5 kommt nach einem Schritt auf 75,7 (OpenCode) und 75,3 (Codex) und liegt damit über den Ausgangswerten von Gemini (72,4 und 74,5).
- Nicht überall vorn: Auf LAB Partial liegt bei Gemini 3.5 Flash mit Codex Meta-Harness vorn.
Für eine Kombination zeigt die erste Abbildung des Papers die Werte je Bereich:
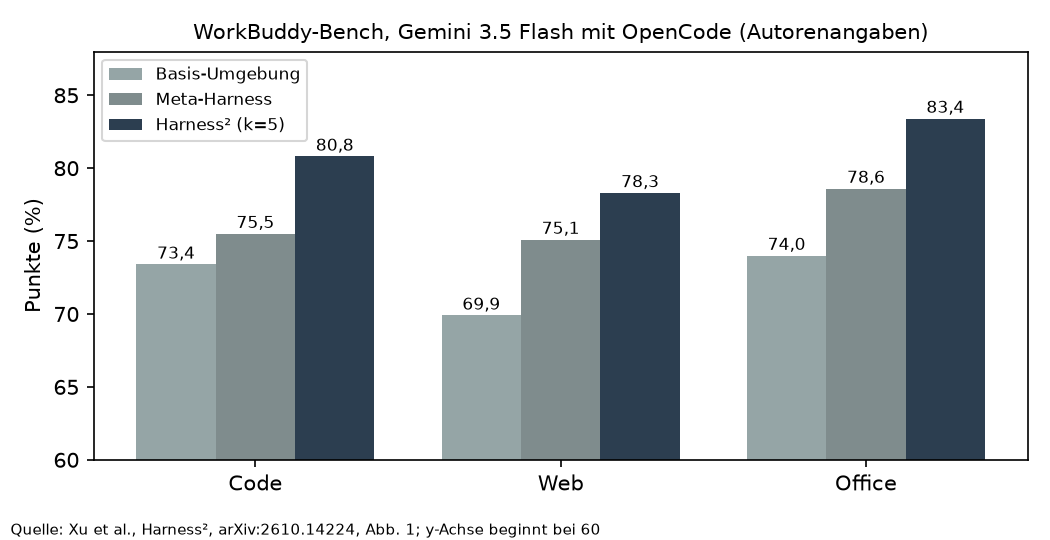
WorkBuddy-Bench je Bereich, Gemini 3.5 Flash mit OpenCode, Harness² mit fünf parallelen Durchläufen. Alle Werte sind Angaben der Autoren, die y-Achse beginnt bei 60. Quelle: arXiv:2610.14224, Abb. 1, ebenso auf der Projektseite.
Was es kostet
Mehr Durchläufe heißt mehr Rechenaufwand. Das Paper vergleicht dazu den gesamten Tokenverbrauch pro Aufgabe, also Ausführung plus Verbesserung. Bei Gemini 3.5 Flash mit OpenCode steigt der Gewinn gegenüber der Basis-Umgebung, wenn k von 1 auf 5 wächst, auf JobBench von 4,5 auf 7,5 Punkte und auf WorkBuddy-Bench von 5,1 auf 8,4. Meta-Harness verbraucht laut Autoren mehr Rechenleistung als Harness² mit k=5 und erreicht dabei weniger.
Im Abschnitt zu den Grenzen räumen die Autoren selbst ein, dass zusätzliche Durchläufe die Inferenzkosten erhöhen. Parallel laufende Sitzungen verkürzen die Wartezeit, sparen aber keine Rechenarbeit. Und weil es keine Musterlösungen gibt, stützt sich die Verbesserung auf Verhaltensvergleiche und das Urteil eines Modells. Das bleibt laut Paper anfällig für Zufallsschwankungen und gemeinsame Verzerrungen der Modelle und garantiert nicht, dass eine Änderung richtig ist oder auf andere Aufgaben übertragbar.
Einordnung
Bewertet werden die Ergebnisse auf allen drei Benchmarks ganz oder teilweise von Sprachmodellen: Auf WorkBuddy-Bench ist laut Anhang Gemini 3.5 Flash als Richter im Einsatz, also eines der getesteten Modelle; JobBench bewertet Claude Opus 4.8, LAB Claude Sonnet 4.6. Das ist bei solchen Benchmarks üblich, heißt aber, dass „Punkte“ hier Urteile eines Modells sind und keine Messung durch Menschen.
Alle Zahlen stammen von den Autoren selbst. Eine unabhängige Nachprüfung habe ich nicht gefunden; das Paper ist ein Preprint und noch nicht begutachtet.
Offen bleibt, ob das Verfahren mit anderen Modellen und Umgebungen genauso gut funktioniert.
Quellen
- arXiv, eingereicht 09.10.2026: Harness²: Recursive Agent Harnessing for an Open World (arXiv:2610.14224)
- Projektseite: harness2.github.io
- GitHub: google-research/harness2
- Harvey, 06.05.2026: Open-Sourcing Harvey’s Long Horizon Legal Agent Benchmark
- GitHub: harveyai/harvey-labs v1.0
- arXiv, 25.05.2026: JobBench: Aligning Agent Work With Human Will (arXiv:2605.26329)
Horidor